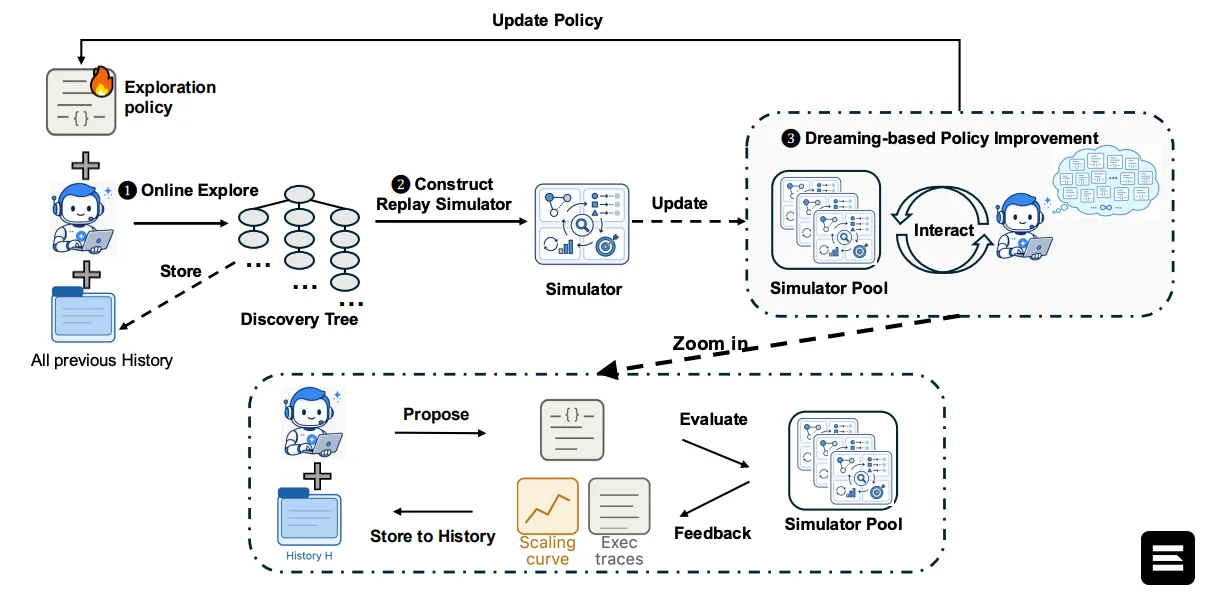
Исследователи Google разработали фреймворк Dream-RSI, позволяющий ИИ-агентам учиться на результатах предыдущих поисков и эффективнее выстраивать стратегию решения задач. Это подход к рекурсивному самосовершенствованию — при этом базовая модель не переобучается, улучшается только программное обеспечение, направляющее поиск.
Система фиксирует каждую попытку поиска в виде дерева с альтернативами, порядком их рассмотрения, вычислительной стоимостью и результатами. Записанная история служит симулятором: агент тестирует разные стратегии навигации по дереву, не запуская заново исходные эксперименты. Наиболее перспективная стратегия применяется в следующем активном поиске.
Google проверил Dream-RSI на восьми задачах в трёх областях — алгоритмическая инженерия, математическая оптимизация и программирование GPU-ядер. В тесте на алгоритм регуляризации Lasso система с Gemini 3.1 Pro достигла среднего времени выполнения 2 931 мс против 3 587 мс у фиксированной стратегии, использовав 317 вызовов агента вместо 550. Версия на Gemini 3.7 Flash снизила среднее время с 2 516,7 до 2 350,6 мс и сократила вызовы с 3 200 до 1 879. Полученные решения превзошли реализации библиотек scikit-learn и glmnet на шести наборах данных.
По сравнению с системой SimpleTES Dream-RSI потребовал в 162 раза меньше вызовов агента. На трёх задачах математической оптимизации результаты сопоставимы или лучше конкурентов при менее чем 1 000 поколениях поиска. В GPU-ядрах производительность выросла в 1,44 и 2,09 раза на двух задачах при аналогичном бюджете.
Исследователи предупреждают, что подход ограничен: система воспроизводит только ранее записанные результаты и не может оценить ветви, которые агент никогда не исследовал. Тесты охватили восемь структурированных задач. Результаты опубликованы на arXiv — сервере препринтов без формальной экспертной оценки.