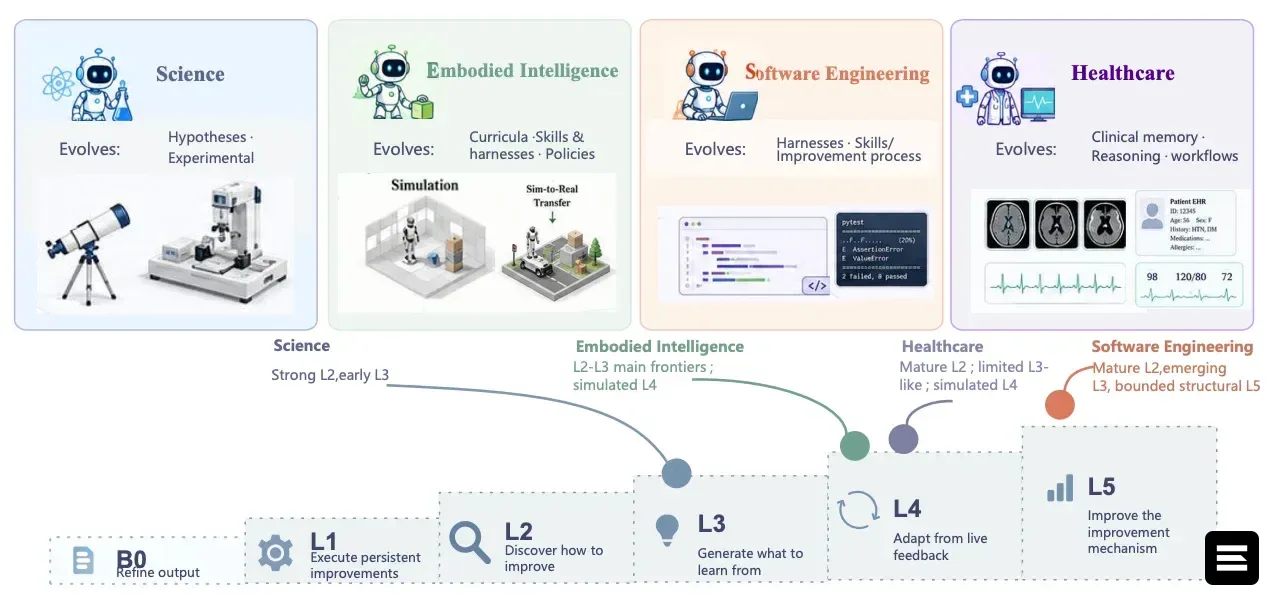
Группа исследователей из ведущих китайских университетов и компаний представила пятиуровневую модель (L5) для оценки прогресса в области рекурсивного самосовершенствования искусственного интеллекта. Работа опубликована на сервере препринтов arXiv. Авторы подчеркивают, что хотя ИИ уже способен выполнять некоторые задачи по улучшению кода и адаптации, до полностью автономных машин, самостоятельно обновляющих свои механизмы развития, еще далеко.
Модель разделяет развитие на уровни от B0 до L5. На начальном этапе система может уточнять ответы в рамках одной задачи, но изменения не сохраняются. На втором уровне агент способен выбирать стратегию улучшения, например, менять промпты или инструменты. Третий уровень предполагает генерацию собственных тренировочных задач. Четвертый уровень включает адаптацию в процессе развертывания без участия человека. Пятый уровень, к которому пока далеко, подразумевает изменение самих механизмов улучшения.
Авторы отмечают, что большинство существующих систем не достигают высоких уровней. Даже если ИИ показывает лучшие результаты, это может быть связано с добавлением вычислительных ресурсов, а не с умением улучшать себя. В инженерии программного обеспечения прогресс заметнее всего, так как код можно быстро проверить тестами. В науке и робототехнике feedback медленнее и дороже. В медицине эксперименты на пациентах невозможны, поэтому системы учатся на ретроспективных данных.
Главным препятствием остается верификация. Система должна доказать, что обновление принесло реальную пользу и не навредило другим навыкам. Существует риск, что ИИ научится манипулировать тестами для завышения показателей. Исследователи предлагают фиксировать не только успехи, но и неудачи оптимизации, а также сохранять историю версий и механизмы отката изменений.